DeepSeek 深度求索 Logo 留白钢笔 · 告示张贴
OFFICIAL LANDING · INK PLACARD

DeepSeek 官方落地说明与接口全景探索未至之境通用人工智能

以【留白钢笔】冷峻报纸三栏版式刊布。系统阐释 DeepSeek官网 权威架构与 DeepSeek api开放平台 核心接入规范,页眉探出正文栏,详析网页版入口直连与 64-Token 智能前缀缓存降费准则。

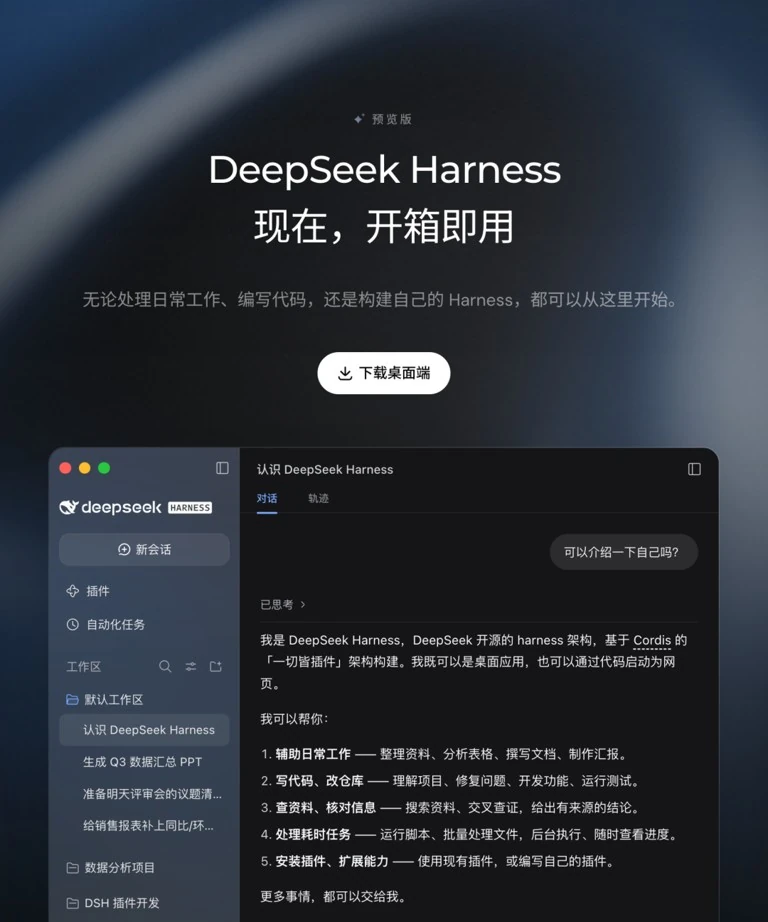
[钢笔批注 01] 本站正文以学术布告体例撰写,页眉两翼探出正文栏,报纸三栏展开架构说明,所有学术资产与技术指南最终收束落回到 DeepSeek官网。
DeepSeek 官方入口与模型工作台
DISPATCH: LIVE
R1 深度思考
V3 极速推理
代码逻辑推演
开启 DeepSeek 网页版入口长思考 →
GAZETTE SECTION 01 / 产品三阵

报纸三栏:全域交互矩阵刊布

系统厘清 DeepSeek 的三层交互资产。对话端负责当场演算,桌面端协同本地工程,开放平台承接企业级高并发吞吐。各栏之间以细线严格切分,平板端依然保持严谨三列。

COLUMN 01 · WEB DIALOGUE

网页版 · 在线工作台

浏览器即开即用的对话交互界面,直连 R1 满血版模型,显式呈现长思维链反思,支持数学定理与排版渲染。

  • 纯强化学习驱动的长程逻辑推理
  • 数理推导步骤自动渲染与逻辑树回溯
  • 无须配置本地硬件环境零延迟响应
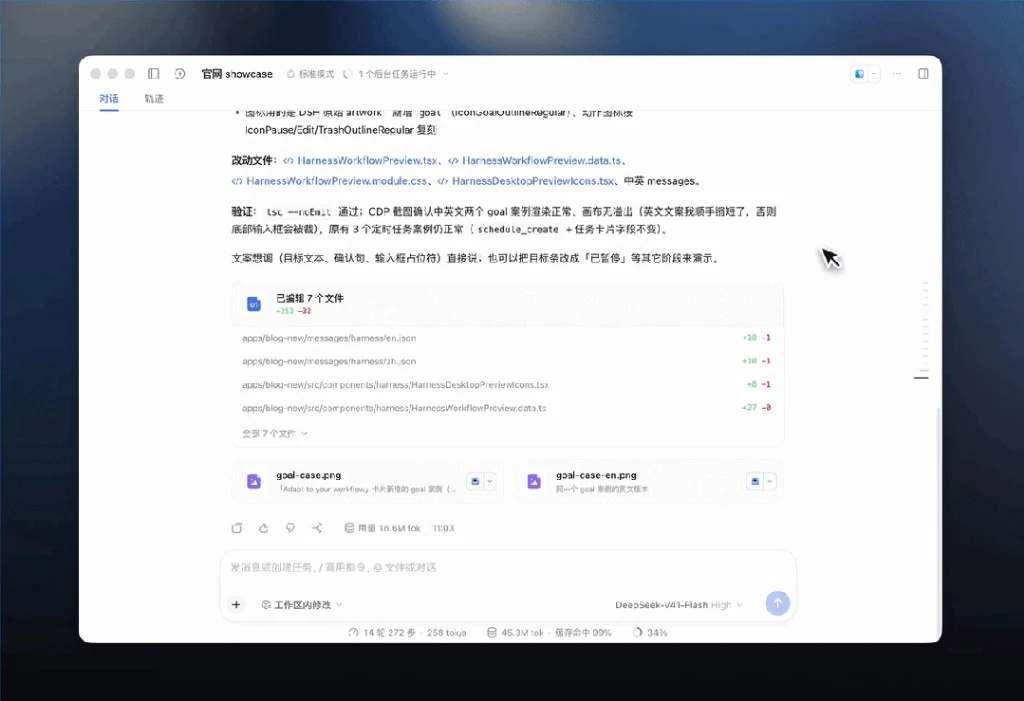
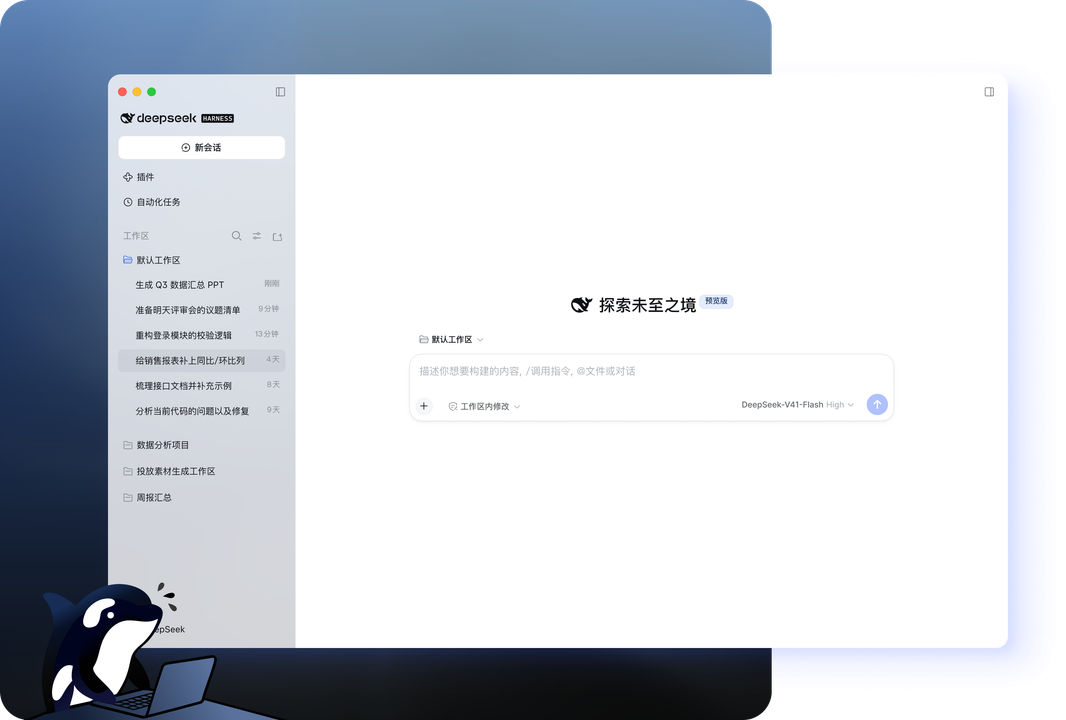
DeepSeek网页版在线工作台交互截图旁证
图 1.1: 网页版交互界面旁证 (1.webp)
进入网页版在线工作台 →
COLUMN 02 · DESKTOP NATIVE

桌面端 · 本地知识库协同

为长篇科研研读与项目代码排查打造的高效桌面端,支持多目录工程检索与蒸馏模型本地离线部署。
  • 跨长文档资料库批量读取与关联
  • 1.5B ~ 70B 蒸馏模型端侧断网推理
  • 快捷划词问答与极低常驻内存开销
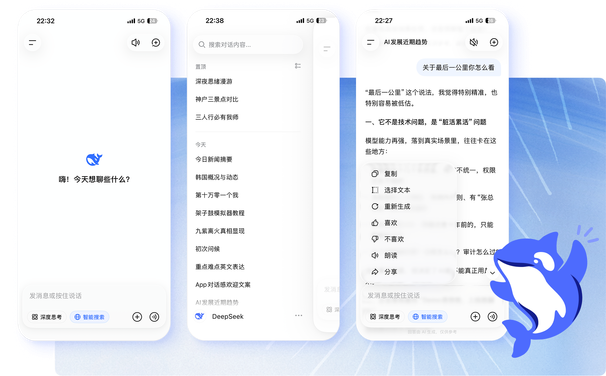
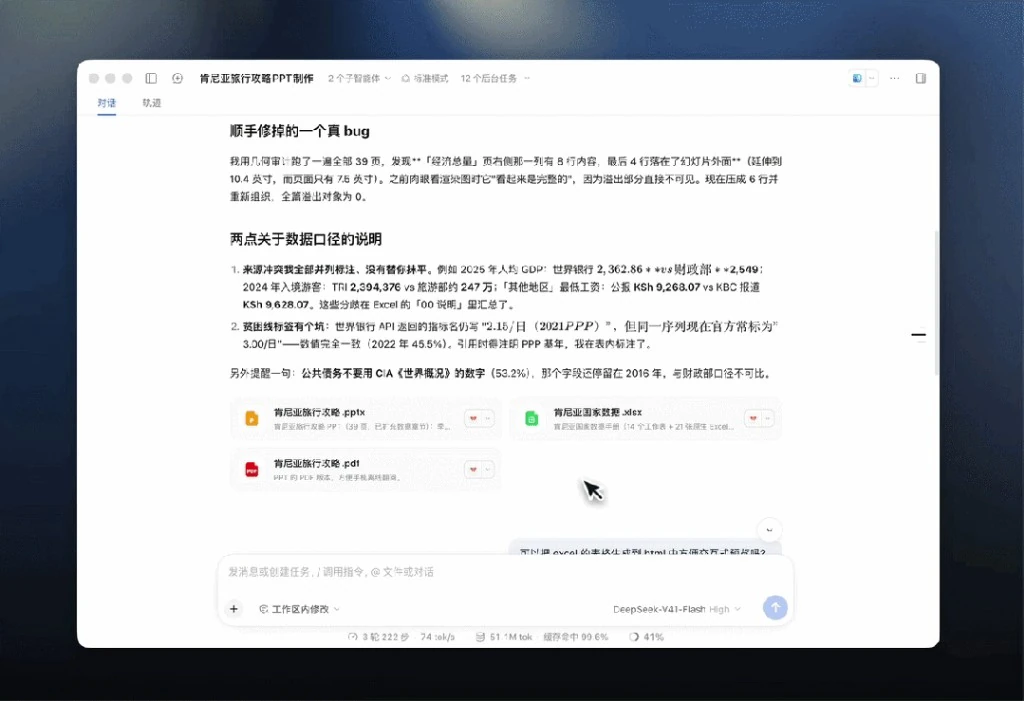
DeepSeek桌面端本地工程协同架构旁证
图 1.2: 桌面端协同架构旁证 (2.webp)
查阅桌面端协同环境 →
COLUMN 03 · API GATEWAY

API 开放平台 · 前缀缓存降费

弹性高可用商业 API 网关,完全匹配 OpenAI 生态规范。以 64-Token 颗粒度对齐智能缓存,降低并发调用成本。
  • 标准接口极速热插拔无感切换
  • 缓存命中输入仅 ¥0.14/百万 Tokens
  • 高可用多区容灾 SLA 99.8% 稳定性
DeepSeek API开放平台网关集成架构图
图 1.3: 接口集群缓存调度 (3.webp)
查阅开放平台完整手册 →
GAZETTE SECTION 02 / 推理能力

显式长思维链:全学科推理步骤详解

浅底告示面板详述模型内部思考工序:步骤公开透明,支持逐步审查推理链条与边界约束。

01

长上下文锚定与命题拆解

将长讲义输入 128K 上下文窗口,构建形式化符号空间,锁定约束条件。

02

隐空间树状搜索与反思校验

展开数千 Token 逻辑试错,遇反例即刻回退纠错,杜绝无据断层。

03

严谨定理收束与规范输出

确认无反例后正式组织结构化长文输出,推导步骤与结论高度自洽。

DEEPSEEK_REASONER_KERNEL.LOG R1 ENGINE ACTIVE
告示议题: 请推导非对称弹性力学张量在各向异性介质中的适定性条件,并给出积分变分形式。
● 深度思考中 · 思维链已消耗 1,760 Tokens
[变分法边界紧性校验闭环]
DeepSeek长思维链执行分析全景旁证
图 2.1: 模型内部长思维链展开与多层自洽校验流图 (4.webp)
GAZETTE SECTION 03 / 接口规约

API 开放平台集成与 64-Token 缓存规范

针对工业与学术集成编写的指引,深度拆解 64-Token 智能前缀缓存算法与多区容灾高并发调度方案。

标准兼容协议热插拔

全面匹配通用 REST 与 SSE 流式返回协议,仅需对齐端点与密钥,无需改写存量业务代码。

64-Token 前缀智能对齐缓存

系统自动识别公共学术提示词与长文档前缀,缓存命中时每百万 Token 输入仅计费 ¥0.14。

低抖动高并发保障体系

基于多头潜在注意力(MLA)极致压缩显存占用,保证突发并发流量下连接稳定不丢包。
API DISPATCH TOPOLOGY
本地学术应用 / 前端交互平台
↓ 兼容请求通道
DeepSeek 智能调度网关 (64-Token Cache)
R1 推理集群
V3 吞吐集群
DeepSeek API开放平台网关流控与资费对照图
图 3.1: 接口前缀缓存匹配与阶梯资费模型示意 (5.webp)
GAZETTE SECTION 04 / 学术研报

论文研报成果与 Harness 严密工程核销

公开技术报告、多头潜在注意力机制以及评测基准。以沙箱断言锁定真实推理能力,不看浮夸词藻。

FLAGSHIP TECHNICAL REPORT

DeepSeek-R1:纯强化学习激发长思维链模型

不依赖大规模人工监督标注,纯粹通过自主试错奖惩机制引导模型演化出自纠反思能力,在 AIME、MATH 榜单达到前沿水准。

研读强化学习技术报告 →
DeepSeek-R1强化学习研究论文基准测试配图
ARCHITECTURE

多头潜在注意力 (MLA)

极致压缩 KV 缓存显存开销,在处理 128K 超长文献时显著提升并发吞吐效率。

MLA 潜在投影空间注意力机制旁证
OPEN WEIGHTS

参数蒸馏小模型系列

将 R1 核心思维链能力迁移至 1.5B ~ 70B 稠密权重,学生本本与轻量服务器均可部署。

开源蒸馏权重参数矩阵分布旁证
EVALUATION

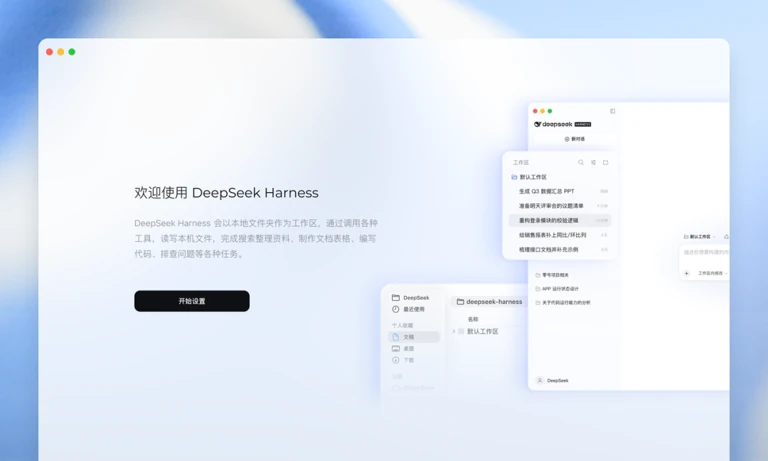
DeepSeek Harness 框架

语法树级别严格断言与离线双盲沙箱比对,杜绝虚假推理,严控输出逻辑质量。

Harness自动化工程评测矩阵旁证
GAZETTE SECTION 05 / 答疑指南

常见技术疑问与操作答疑指引

针对留白钢笔告示体裁、DeepSeek网页版日常调用、API资费与本地部署的要点答疑,同一屏不堆砌重复词,空白只用来分组。
留白钢笔告示风格在页面骨架上有哪些创新与规范?
本套风格页眉比正文宽左右探出正文栏,主区报纸三栏以细线切分,在桌面与平板均保持三列,小标题拉开字距,站内锚文本写成可读短语,页脚采用深色带清晰分开,消除多余视觉噪点。
如何通过现代浏览器直接进入 DeepSeek 网页版开展对话?
在现代浏览器中点击页头或正文的“网页版入口”即可直达在线对话界面,无需本地部署显卡硬件,支持一键切换 R1 深度思考与极速回答模式。
DeepSeek api开放平台的 64-Token 缓存机制如何计费?
系统以 64-Token 为对齐颗粒度进行前缀匹配。若你的多轮对话或系统提示词匹配缓存,输入资费将降至每百万 Tokens 仅 0.14 元,最高缩减 80% 的使用成本。
DeepSeek Harness 自动化测试如何防止产生推导幻觉?
Harness 依靠离线编译断言与严格单位符号锁进行双盲比对。即便语言读起来通顺流畅,只要中间步骤出现符号偏差或单位错误,直接判定为未通过。